私有云同步相册/文件(OneDrive)
核心模块:
- 网络与通信模块(frp、CORS、RESTful)
- 文件传输模块(Multipart、分片、合并)
- 同步与算法(哈希、秒传、增量同步)
- 多端客户端模块(线程、MediaStore、IPC)
网络与通信模块:
内网穿透:使用自有租赁VPS部署frps,服务器使用frpc进行内网穿透式的端口映射。
跨域(CORS):5173端口的Vue请求8080的SpringBoot时,浏览器检测到Vue的JS请求了不同源的接口,主动拦截,否则可能会被恶意网站偷发请求进行CSRF攻击;只需在服务端响应头加入Access-Control-Allow-Origin: *声明接口可被调用。
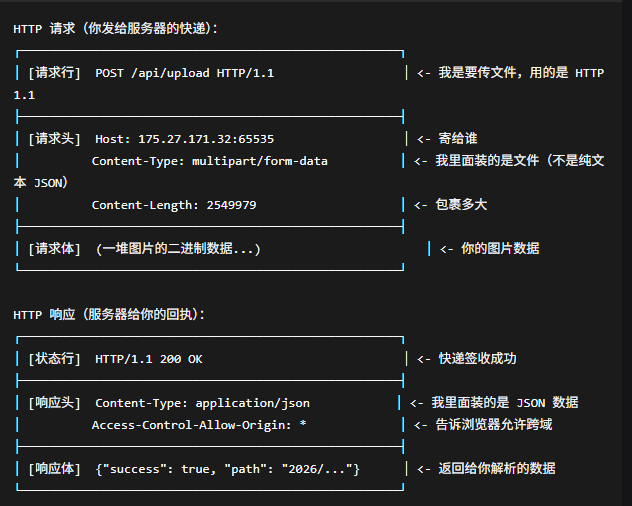
RESTful 与 HTTP 协议:HTTP 是快递单,RESTful 是填单子的规范。POST 用来新建(提交上传文件),GET 用来查询(查已上传的分片、查同步变更)。multipart/form-data 是专门用来传二进制文件(图片、视频)的信封,而普通的文本数据一般用 application/json。
Q/A:
1.企业也用frp吗?
一般不用,大部分使用Ngrok,花生壳,阿里云/腾讯云的API网关;请求一般先到 网关/负载均衡服务器 再转发到内网服务器。
2.跨域安全风险如何解决?
两种标准做法:
- 设置白名单(最常用):不要让所有人都能跨域,只允许你的域名。比如:javaregistry.addMapping(“/**”) .allowedOrigins(“https://yourdomain.com”, “http://localhost:5173”) // 生产+开发环境 .allowedMethods(“GET”, “POST”, “PUT”, “DELETE”);
- 同源部署(免跨域):这是最彻底的。把你的 Vue 打包成静态文件(一堆 HTML/JS/CSS),放到 Nginx 里面,让 Nginx 的 80 端口既托管前端页面,又反向代理
/api到 Spring Boot(8080)。这样浏览器看到的前端和后端都是https://yourdomain.com,端口、域名、协议全一样,根本不存在跨域。
3.图解 HTTP 与 RESTful
4.Http加密过程?
HTTPS 的加密过程,分两个阶段:
- 握手阶段:用非对称加密(RSA/ECDHE) 和 CA 证书机制,安全地商量出一个“对称密钥”。(解决了防冒充、防篡改)
- 通信阶段:用这个“对称密钥”(AES)去对称加密真正的业务数据,也就是照片和密码。(解决了效率问题,防窃听)。
文件传输模块:
指纹(SHA-256):每个文件使用SHA-256计算出一个哈希值,方便后面的秒传/合并验证。
断点(/api/chunk/status):客户端询问服务端的指纹和总片数,服务端在storage/temp/{sha256}/中查找分片,返回接收到的片,客户端接收到返回值验证还有哪些需要断点续传,只传对应的片即可。
传分片(/api/chunk/upload):客户端按照 1MB 的大小切割文件,用 HTTP 的 multipart/form-data 把 切片数据、指纹、当前是第几片 发给服务端。服务端收到后,在 temp/{sha256}/ 目录下,创建一个叫 4.part 的文件,把字节写进去。项目里是 for 循环一片一片传的。在生产环境里,通常会让 3~5 个分片同时并发上传,大幅提升速度。(但并发传会打乱顺序,所以才需要第四步)。
合并(/api/chunk/merge):客户端发现所有分片都传完了,发一个 POST 请求告诉服务端分片已全部传输完成。服务器循环累计把文件合并回一个完整文件,删除temp/{sha256}目录,把文件挪到正式区。
Q/A:
1.为什么不把合并的逻辑写在上传分片的接口里?
- 原因 1:如果每传一片都去检查一遍“是不是全都传齐了”,不仅极其消耗 CPU 和磁盘 IO,还会导致并发冲突。
- 原因 2(核心):职责分离。
upload只负责接收和落盘,merge只负责校验和拼接。网络断开时,只要merge没触发,临时文件就一直保留着,下次还能续传。
2.并发上传打乱顺序了,怎么保证合并出来的文件是好的?
- 约定的文件名:
0.part、1.part、2.part。 - 合并的时候,服务端代码是
for (int i = 0; i < total; i++),是死板地按数字顺序读文件的。无论客户端是并发传还是乱序传,只要文件名叫5.part且内容没错,合并时一定会被排在第 6 个位置。
同步与算法:
秒传的底层逻辑(SHA-256 哈希):客户端计算上传文件的哈希,与服务器对比,查询到直接显示成功,不会进入上传进程。
增量同步(Change Log + Seq 序列号):引入了一个单调递增的序号(Seq),服务端每发生一次“新增”或“删除”,就给这个动作编个号(seq = 1, 2, 3...),记在ChangeLog里;客户端本地记住lastSeq;下次同步时,客户端带 since=lastSeq 去查询变化;服务器只需要返回比这个数字大的记录,数据传输量极小。
内存与磁盘的一致性:
启动时重建:你的代码里 @PostConstruct 的时候扫描磁盘,重建内存 Map。这叫“数据以磁盘为唯一真相源(Single Source of Truth)”。
实时校验:读取索引时,顺手检查一下真实文件在不在(你后来修复 bug 就是这么干的)。
企业级做法:引入数据库(MySQL)作为中间层。由于文件在磁盘、索引在数据库,一般会有一个“巡检任务”,每天对比数据库和对象存储,修复死链。
Q/A:
1.哈希碰撞攻击怎么办?
服务端在合并时,不能只信客户端,要自己算一遍合并后文件的真实哈希。如果发现合并后的哈希对不上,直接丢弃。
2.客户端太久未同步,产生大量同步日志如何下载?
- 分页拉取:别一次性拉 10000 条。服务端规定一次只返回 100 条。客户端拉取
since=0,拿到第 1 到 100 条,以及nextSeq=100;然后客户端再带着since=100拉下一次。这就是为什么微信朋友圈有“下拉加载更多”。 - 快照(Snapshot)机制(更高级):真实的同步系统里,ChangeLog 不会无限保留。比如你的服务器规定只保留 30 天的日志。如果客户端离线了一年,它带的
lastSeq早就在服务器日志里被淘汰了。这时候服务端会直接告诉客户端:“你的记录过期了,别拉日志了,我直接给你一份当前最新的全量列表(Snapshot)吧”。客户端清空本地,直接下载全量,然后重新开始同步。